Prompt tracking: o que acontece quando a IA responde à mesma pergunta centenas de vezes
Por que uma checagem manual não é monitoramento, e o que os dados revelam quando você faz isso certo, com frequência e em escala.
- Rodar o mesmo prompt 100 vezes no ChatGPT quase nunca traz a mesma lista de marcas duas vezes
- A métrica que importa não é a posição, é a consistência de aparição ao longo do tempo
- Uma pergunta do seu cliente pode virar dezenas de buscas invisíveis que a IA faz sozinha
- Usar o nome da própria marca como prompt de teste distorce os dados sem você perceber
Toda segunda-feira de manhã, alguém abre o ChatGPT, digita o nome da empresa e cola o resultado num Slack interno com a mensagem: "olha, aparecemos!". A equipe reage com um emoji de foguete. O gestor de marketing respira aliviado. E a semana começa com a sensação de que a presença na IA está sendo monitorada.
Mas não é bem assim…
O que está acontecendo ali é uma checagem manual, pontual e não-replicável de um sistema que por natureza nunca responde duas vezes da mesma forma. É o equivalente a medir a temperatura de uma cidade inteira com um termômetro instalado no meio de uma praça, uma vez por semana, e concluir que o clima está estável.
Nesse caso, o problema não é a intenção, mas a metodologia. E a diferença entre uma checagem casual e um prompt tracking real não é apenas técnica. É a diferença entre uma impressão subjetiva e um dado que você consegue defender numa reunião de diretoria, comparar mês a mês e transformar em ação.
Pensando nisso tudo, criamos este para abrir essa distinção com a profundidade que ela merece. O que é prompt tracking de verdade, por que ele funciona de forma completamente diferente do que intuitivamente parece e, no final, o que você pode fazer com esses dados quando eles são coletados da forma certa.
O que é prompt tracking (e o que ele não é)
O prompt tracking é o processo de monitorar, de forma sistemática e contínua, o que as IAs generativas respondem quando recebem perguntas relacionadas à sua marca, ao seu mercado ou aos seus concorrentes. Não uma vez e não manualmente. E também, claro, não só no ChatGPT.
A palavra-chave aqui é sistemático! Um sistema de prompt tracking funciona da seguinte forma:
-
Você cadastra os prompts que representam as perguntas reais do seu cliente: aquelas que ele faria num momento de busca, comparação ou decisão de compra.
-
Esses prompts são executados automaticamente, todos os dias, nos modelos de IA que você quer monitorar.
-
Cada resposta gerada é capturada e analisada: sua marca apareceu? Com link ou apenas mencionada? Com qual sentimento? Ao lado de quais concorrentes?
-
Esses dados são acumulados ao longo do tempo, revelando padrões, tendências e variações que uma checagem manual nunca conseguiria capturar.
Agora, o que o prompt tracking não é?
Abrir o ChatGPT, digitar o nome da sua empresa e printar a resposta. Também não é fazer isso uma vez. E também não é monitorar apenas um modelo de IA, como se o ChatGPT representasse todo o ecossistema, quando ele representa, na melhor das estimativas, menos da metade das conversas que acontecem em plataformas generativas hoje.
A distinção importa porque sem ela, você pode estar tomando decisões de conteúdo, posicionamento e investimento com base em dados que talvez não tenham tanta validade estatística. E o pior cenário não é saber que você não está aparecendo, mas acreditar que está, porque checou uma vez e apareceu.
A IA não é um buscador, e isso transforma a forma como mensuramos presença
Quando você pesquisa algo no Google, o resultado é, dentro de uma margem pequena, determinístico. A mesma query, feita por pessoas diferentes, em momentos diferentes, tende a retornar uma ordem parecida de resultados. É por isso que o SEO tradicional pôde construir toda uma disciplina em torno de posições: a posição 1, a posição 3, a primeira página.
As IAs generativas funcionam de forma radicalmente diferente. Elas são motores probabilísticos, o que significa que a mesma pergunta, feita para o mesmo modelo, no mesmo dia, pode gerar respostas completamente distintas. E isso não é instabilidade técnica. É parte essencial de como esses sistemas foram projetados.
A pesquisa que ninguém queria fazer e o que ela revelou
Em janeiro de 2026, Rand Fishkin, cofundador do SparkToro, publicou uma das pesquisas mais importantes e incômodas do mercado de visibilidade em IA. O estudo envolveu 600 voluntários que executaram 12 prompts idênticos através do ChatGPT, do Claude e do Google AI (AI Overviews e AI Mode). Um total de 2.961 execuções ao longo de novembro e dezembro de 2025.
A pergunta central era simples, mas ninguém havia investigado com rigor suficiente antes: as IAs são consistentes o bastante para que o rastreamento de posição faça sentido como métrica?
A resposta foi direta: para cada prompt rodado 100 vezes no ChatGPT ou no Google AI, a chance de receber a mesma lista de marcas duas vezes é menor que 1 em 100. A chance de receber a mesma lista na mesma ordem é menor que 1 em 1.000.
A conclusão do próprio Fishkin foi explícita: qualquer ferramenta que venda "posição de ranking em IA" como métrica está vendendo uma ilusão. A posição não existe como conceito estável nesse ambiente.
Mas (e esse é o ponto mais importante da pesquisa) isso não significa que rastrear prompts é inútil. Significa que a métrica certa não é posição. É consistência de aparição.
O que é estável
Quando Fishkin analisou os dados com mais profundidade, um padrão emergiu. Mesmo com a enorme variação nas listas e nas ordens, as marcas que apareciam com mais frequência em determinadas categorias tinham uma taxa de aparição estável, independentemente de como a pergunta era formulada.
No mercado de fones de ouvido, por exemplo, marcas como Sony, Bose e Apple apareciam em 55% a 77% das respostas, sem importar a variação de prompt. No mercado de computação em nuvem, os players dominantes apareciam na maioria esmagadora das execuções.
Esse conjunto de marcas que a IA consistentemente considera quando responde perguntas sobre uma categoria tem um nome: o consideration set. E é nele que a disputa real acontece. Entrar no consideration set de uma categoria no ChatGPT, no Perplexity e no Gemini é o equivalente moderno de aparecer na primeira página do Google, com a diferença de que o mecanismo para chegar lá é diferente, e a medição que prova que você chegou também.
O que o prompt tracking sistemático faz é medir, ao longo do tempo, se a sua marca está entrando, se mantendo ou saindo desse conjunto. Ou seja…não onde você aparece, mas com qual frequência você aparece.
Fan-out: uma pergunta do seu cliente vira várias consultas da IA
Tem um conceito antigo, mas muito comentado ultimamente e que transforma bastante a forma como você pensa sobre os prompts do seu banco de monitoramento: o fan-out query.
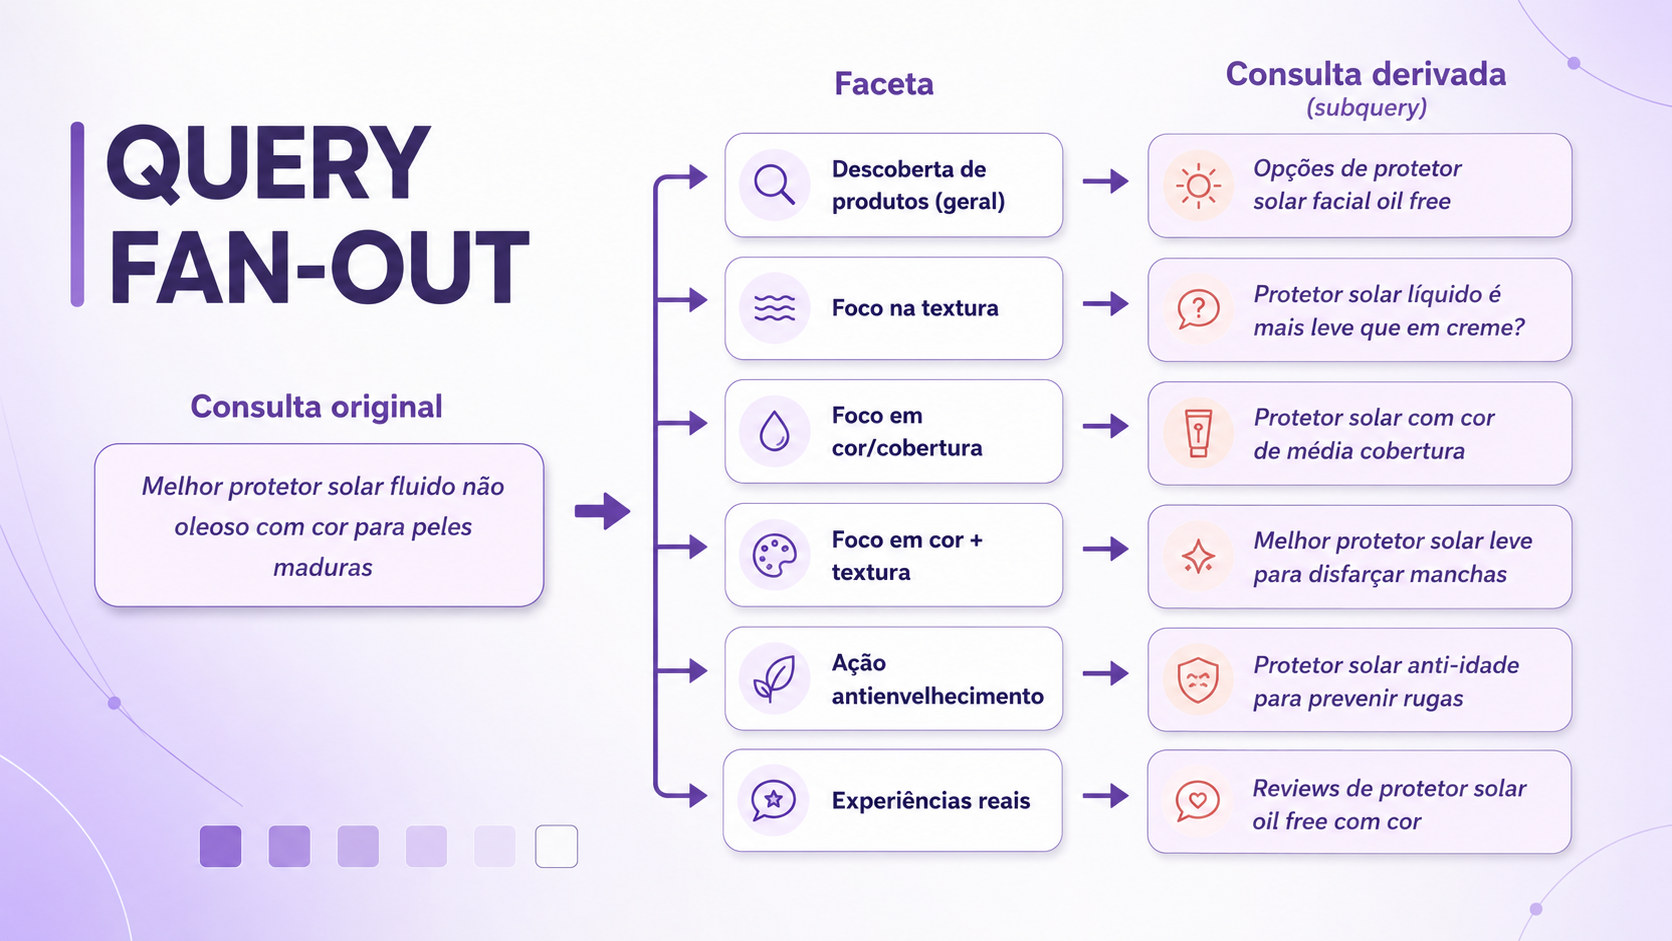
Quando um usuário digita uma pergunta longa ou complexa para uma IA com acesso à web: "quero contratar uma agência de SEO especializada em e-commerce, com experiência em AI Search e conteúdo", o modelo não processa isso como uma consulta única. Ele decompõe a intenção em sub-perguntas menores e mais específicas, faz buscas separadas para cada uma delas, e depois sintetiza as respostas numa resposta coesa para o usuário.
Na prática, isso significa duas coisas importantes para quem está construindo um banco de prompts de monitoramento:
-
Um prompt amplo no seu painel pode acionar múltiplas sub-consultas que não são diretamente visíveis para você. O que você monitora é o resultado final — a resposta que o usuário recebe —, mas a IA chegou até ali por um caminho que envolve perguntas menores.
-
O conteúdo que a IA encontra nessas sub-consultas determina o que entra na resposta final. Isso significa que aparecer bem em perguntas específicas e técnicas pode ser mais valioso do que aparecer superficialmente em perguntas amplas.
Para o monitoramento, a implicação prática é que prompts fechados e específicos tendem a gerar dados mais acionáveis do que prompts genéricos. Uma pergunta como "qual ferramenta de monitoramento de IA é mais indicada para equipes de marketing de médio porte no Brasil?" captura uma intenção muito mais precisa e, por isso, os dados que ela gera dizem algo muito mais concreto sobre onde você está falhando ou onde está se destacando.
Prompts genéricos geram dados genéricos. Prompts próximos das perguntas reais do seu cliente geram diagnósticos acionáveis.
Por que a checagem manual não funciona como monitoramento
Voltemos à cena da segunda-feira de manhã. O gestor abriu o ChatGPT, fez a pergunta, apareceu. Ótimo.
Mas o que essa checagem não captura é enorme.
Ela não captura o que a mesma IA responderia para a mesma pergunta se você repetisse 50 vezes. Ela não captura o que o Perplexity responde, que pode ser completamente diferente porque as fontes que ele prioriza têm menos de 11% de sobreposição com as fontes que o ChatGPT usa para as mesmas perguntas, como mostrou uma análise de Joshua Blyskal com 100 mil prompts.
Ela também não captura como a resposta mudou nos últimos 30 dias. Ela não captura com qual sentimento você apareceu e se a IA te recomendou como a melhor opção ou te listou como "também existe". E ela certamente não captura nenhum dos concorrentes que apareceram nas 49 outras execuções daquele mesmo prompt no mesmo dia.
A escala é o problema central. Uma empresa monitorando 30 prompts em três modelos de IA diferentes precisaria de 90 execuções por dia para ter dados diários. Feitas manualmente, leria respostas, registraria resultados, compararia com o mês anterior. É operacionalmente inviável para qualquer equipe de marketing com mais responsabilidades do que isso.
E mesmo que você tivesse o tempo, o dado de uma execução única de um prompt não tem validade estatística suficiente para orientar decisões. A variabilidade natural das IAs exige que o mesmo prompt seja rodado múltiplas vezes para que os padrões se consolidem e os dados reflitam algo confiável sobre a posição da sua marca.
O que rastrear e como os dados se transformam em diagnóstico
Com um sistema de prompt tracking funcionando, o que você está medindo não é posição, mas presença. E presença, nesse contexto, se desdobra em algumas dimensões que têm implicações práticas diferentes.
Frequência de aparição
O primeiro número a olhar é a Visibilidade! A porcentagem dos prompts monitorados em que sua marca apareceu, de qualquer forma. Se você rodou 100 prompts e apareceu em 40, sua Visibilidade é 40%.
Esse número não discrimina menção de citação, positivo de neutro. Ele responde apenas: você está presente nessa conversa? E quando a resposta é não (quando a visibilidade está baixa) nenhuma outra métrica tem como compensar isso. A IA simplesmente não está te reconhecendo nos contextos que você está monitorando.
Visibilidade baixa com prompts bem construídos é um sinal claro de problema de conteúdo ou autoridade técnica. Visibilidade baixa com prompts genéricos pode ser simplesmente um sinal de que os prompts precisam ser revistos. É como se o território que você está monitorando não fosse o mesmo território onde seus clientes realmente buscam.
Share of Voice: você está ganhando ou perdendo espaço?
Enquanto a visibilidade diz se você aparece, o share of voice diz como você aparece em relação à concorrência. É a sua fatia do total de aparições (citações e menções) dentro do grupo de concorrentes que você monitora.
É o número que costuma entrar na reunião de diretoria: estamos crescendo ou perdendo espaço para os concorrentes nas respostas da IA? Se o seu SoV caiu de um mês para o outro sem que você tenha feito nada de diferente, significa que algum concorrente ganhou terreno: publicou conteúdo novo, obteve cobertura em fontes que as IAs valorizam, ou melhorou sua estrutura técnica. O monitoramento contínuo é o que permite identificar esse movimento antes que ele se consolide.
Menção ou citação: a IA te conhece ou te usa como fonte?
Dentro de cada aparição, o tipo de aparição importa. Uma menção é quando a IA escreve o nome da sua marca no texto da resposta, mas sem link. Uma citação é quando ela vai além e entrega um link direto para o seu site, tratando seu conteúdo como fonte confiável.
Muitas menções e poucas citações é um diagnóstico preciso: a IA te conhece, mas não usa seu conteúdo como referência técnica. Esse gap entre os dois números aponta para um problema de autoridade de conteúdo, não de branding. A solução não passa por aumentar o reconhecimento de marca, mas passa por produzir conteúdo mais estruturado, mais específico e mais acessível para os crawlers das IAs.
Sentimento: aparecer está fazendo bem ou mal?
Uma marca pode ter Visibilidade alta, Share of Voice expressivo, e ainda assim estar sendo prejudicada! Isso acontece quando o sentimento com que ela aparece é misto ou negativo, quando a IA recomenda com ressalvas, compara desfavoravelmente ou associa o nome da empresa a uma experiência ruim.
O sentimento é capturado por um modelo de linguagem que lê o contexto ao redor de cada aparição e classifica a polaridade. E é a métrica mais relevante para decisões de reputação e conteúdo: ela revela não só se você aparece, mas como aparece, e se esse "como" está ajudando ou atrapalhando a jornada de decisão do seu cliente.
Por que monitorar só o ChatGPT é como ler metade da história
Um dos problemas mais comuns de quem começa a monitorar presença em IA é tratar todas as plataformas como equivalentes, ou monitorar apenas uma delas e extrapolar para o ecossistema todo.
Cada plataforma tem suas próprias fontes de referência, seus próprios critérios de confiança por domínio e seu próprio padrão de comportamento.
O ChatGPT tende a citar Wikipedia, veículos de imprensa de alta autoridade e plataformas como o Zapier, que aparece como a fonte mais citada em tecnologia digital no ChatGPT, mas ocupa apenas a 44ª posição em menções de marca. O Perplexity prioriza Reddit e fontes especializadas por segmento. O Google AI Overviews puxa fortemente de YouTube, Quora e fontes localizadas por país.
Isso tem implicações diretas para a estratégia de conteúdo. Se o sentimento da sua marca é bom no ChatGPT mas problemático no Perplexity, o foco deve ser nas fontes que o Perplexity prioriza. Se o problema está no Google AI Overviews, o olhar vai para conteúdo em vídeo, publicações em plataformas colaborativas e fontes localizadas.
Plataformas diferentes, origens diferentes, soluções diferentes.
Monitorar por plataforma, não apenas por prompt, é o que transforma o diagnóstico de "estamos com problema de visibilidade" em "estamos com problema de visibilidade no Perplexity, e a origem provavelmente são as discussões no Reddit que captam reclamações de suporte de dois anos atrás". Essa granularidade é o que separa dado de inteligência.
Frequência de execução: por que um relatório mensal não é suficiente
Dada a variabilidade natural das IAs, frequência de execução e volume de dados são o que transformam resultados ruidosos em padrões que você pode confiar na hora de pensar em estratégia de crescimento.
Imagine que você rodou um prompt uma vez e a IA respondeu sem citar sua marca. O que isso prova? Absolutamente nada. Talvez ela citasse se você rodasse de novo, ou talvez fosse um dia em que o modelo priorizou outra fonte. Talvez sua marca apareça em 60% das execuções e essa foi uma das 40% em que não apareceu.
A pesquisa do SparkToro que comentamos mais acima sugere que 60 a 100 execuções do mesmo prompt começam a gerar dados estatisticamente confiáveis sobre frequência de aparição. É só a partir desse volume que o "sua marca aparece em X% das respostas" deixa de ser um número aleatório e passa a refletir algo real sobre a percepção do modelo.
Executar prompts diariamente resolve dois problemas de forma elegante: volume e temporalidade. Ao longo de 30 dias, cada prompt acumula 30 execuções, o suficiente para revelar padrões consistentes. E a cadência diária garante que você consegue identificar quando algo mudou, não só o que mudou.
Se um concorrente lançou um produto, recebeu cobertura relevante na imprensa ou publicou um estudo que ganhou tração, o impacto no Share of Voice tende a aparecer nos dados em dias, não em meses. Com execuções diárias, você identifica esse movimento na semana em que ele acontece, em vez de no relatório mensal seguinte, quando já seria tarde para reagir.
Execuções diárias transformam o painel de um relatório em um sistema de alerta. A diferença entre saber que sua visibilidade caiu e saber que sua visibilidade caiu na última semana, provavelmente em função de um evento externo identificável, é a diferença entre reagir e agir.
Construindo um banco de prompts que gera dados acionáveis
A qualidade dos dados de um sistema de prompt tracking é diretamente proporcional à qualidade dos prompts que alimentam esse sistema. Prompts genéricos geram dados genéricos. Por outros lado, se você constrói prompts que refletem as perguntas reais dos seus clientes, os diagnósticos gerados permitem que você entre em ação com muito mais base.
A distinção mais importante que existe na construção de um banco de prompts é entre dois tipos funcionalmente diferentes:
Prompts de presença orgânica
São os prompts que simulam como o seu cliente busca informação sem saber que a sua marca existe. A IA é colocada no papel do consumidor neutro. Eles medem visibilidade espontânea, Share of Voice e posicionamento no contexto do mercado.
São os prompts mais estratégicos do banco, porque capturam exatamente o que acontece quando alguém usa a IA para descobrir fornecedores, comparar opções ou buscar recomendações no seu segmento.
Exemplo:
"Qual ferramenta de monitoramento de marca nas IAs vale a pena para agência de marketing?" ou "Como saber se minha empresa aparece nas respostas do ChatGPT?"
Prompts de análise de sentimento
São os prompts que perguntam diretamente sobre a marca, o produto ou o concorrente. Eles avaliam o que a IA sabe, como ela avalia e com qual tom ela descreve. Medem reputação codificada no modelo, o tom das respostas e o conhecimento dos diferenciais.
Exemplos:
"O que as pessoas falam sobre a [marca]?" ou "A [marca] é uma boa opção para [caso de uso]?"
A proporção ideal entre os dois tipos depende dos objetivos do monitoramento. Para quem está começando, uma distribuição de 70% de prompts de presença orgânica e 30% de análise de sentimento tende a gerar os dados mais úteis nos primeiros meses.
Cobertura temática, não volume bruto
A riqueza de um banco de prompts não está no número de conversas, mas na diversidade de territórios que eles cobrem. Dez prompts sobre o mesmo tema são menos valiosos do que dez prompts que cobrem ângulos genuinamente diferentes, etapas diferentes da jornada, intenções diferentes e perfis de usuário diferentes.
Um banco bem estruturado cobre pelo menos quatro etapas da jornada do cliente em cada categoria temática estratégica:
- Descoberta: perguntas de quem ainda não sabe o que precisa.
"O que é monitoramento de presença em IA?"
- Problema: perguntas de quem está descrevendo uma dor.
"Minha marca não aparece no ChatGPT, o que fazer?"
- Avaliação: perguntas de quem está comparando opções.
"Qual a melhor ferramenta de GEO para empresa de médio porte?"
- Decisão: perguntas de quem está quase pronto para agir.
"Vale a pena contratar monitoramento de IA agora ou esperar o mercado amadurecer?"
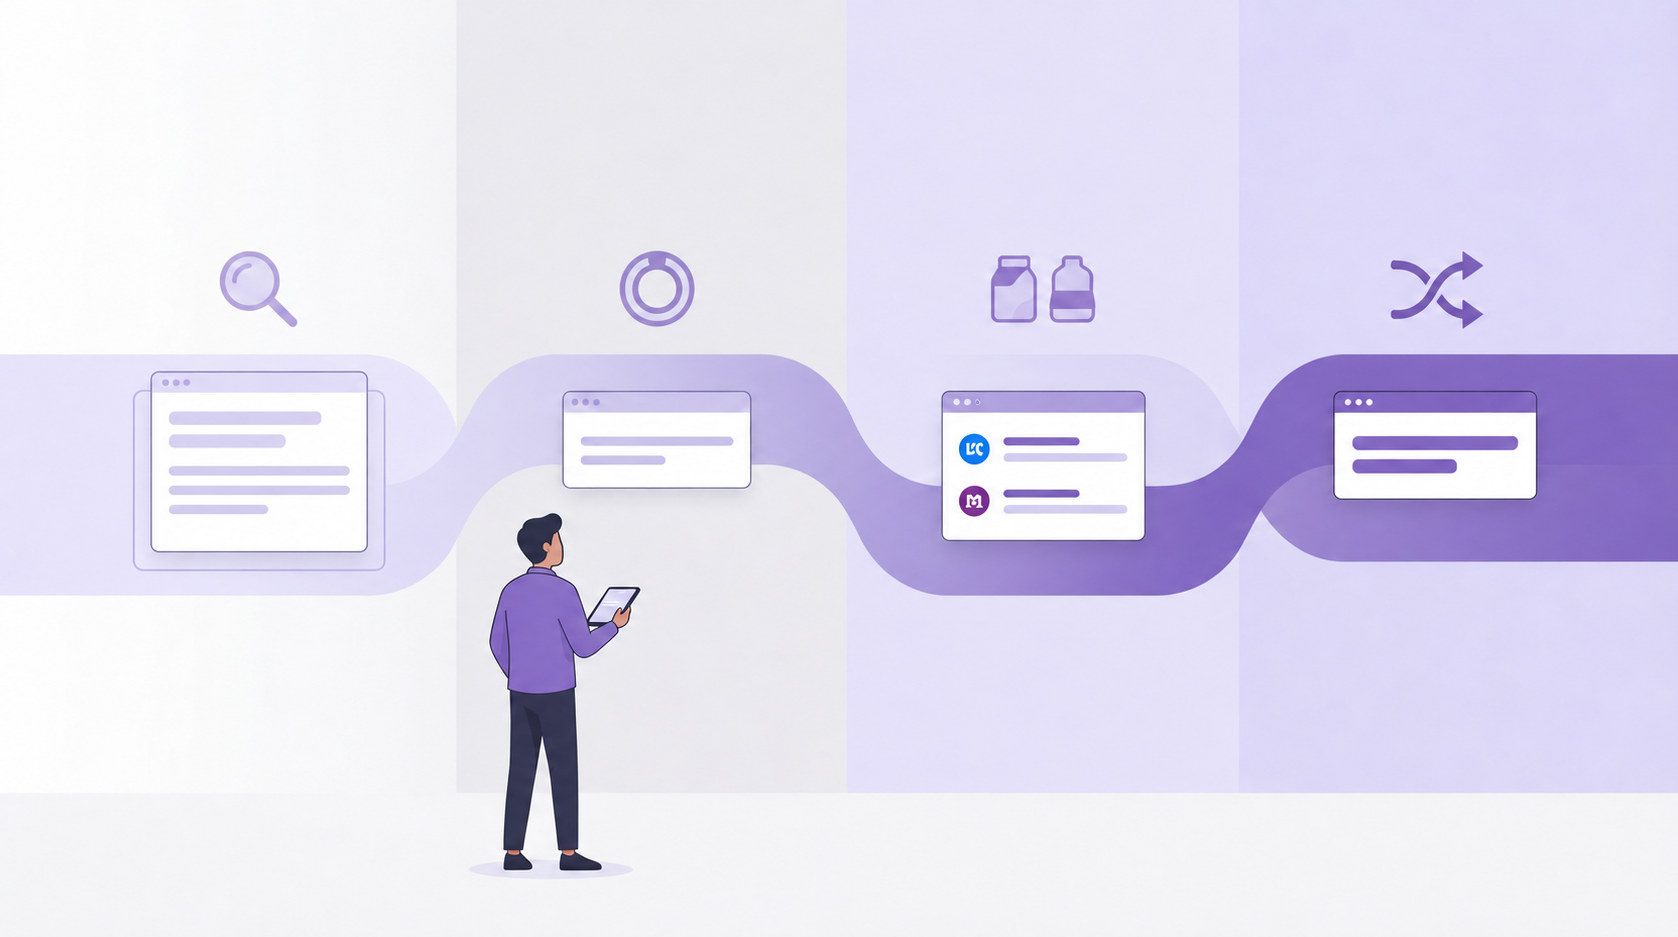
Cada etapa captura sua marca em um momento diferente da jornada, e os dados gerados por cada uma têm implicações diferentes para a estratégia de conteúdo e posicionamento.
O que fazer com os dados: ações práticas para marcas
Prompt tracking é só o começo! O valor dos dados está no que eles revelam sobre onde agir, e essa revelação é muito mais precisa do que qualquer estratégia construída em cima de checagens manuais ou suposições sobre o que a IA sabe sobre você.
Estabeleça uma linha de base antes de qualquer coisa
A primeira coisa que o monitoramento produz é um benchmark: onde você está hoje. Sem esse número, qualquer mudança que você fizer (de conteúdo, de reputação, de estrutura técnica) não tem como ser medida. Você vai saber que fez algo, mas não saberá se funcionou.
Use as primeiras duas ou três semanas de dados para estabelecer a linha de base da sua Visibilidade, Share of Voice, proporção de citações e sentimento médio. Esse é o ponto zero a partir do qual qualquer melhora ou piora vai fazer sentido.
Cruze a visibilidade com as categorias de prompt
Visibilidade baixa agregada é um diagnóstico genérico demais para gerar ação. O que transforma o dado em briefing é cruzá-lo com a categoria de prompt onde ele aparece.
Se você ainda não aparece nos prompts de decisão, mas aparece razoavelmente nos de descoberta, o problema pode ser de fundo de funil: seu conteúdo não está respondendo as perguntas que um comprador faz no momento de escolher. Se você está invisível nos prompts comparativos, mas aparece bem nos de problema, é possível que a questão maior seja com a sua autoridade técnica em relação aos concorrentes diretos.
Cada categoria de prompt tem uma origem diferente para os problemas que ela revela e, consequentemente, uma solução diferente. Tratar tudo como o mesmo problema é o caminho mais rápido para desperdiçar esforço de conteúdo.
Identifique onde concorrentes aparecem e você não
Os prompts onde concorrentes são citados e você é ignorado são, na prática, os briefings de conteúdo mais valiosos que você pode ter. Eles indicam exatamente quais perguntas a IA já sabe responder com referências confiáveis, e para as quais o seu conteúdo ainda não é considerado suficiente.
Analise o tipo de pergunta desses prompts: é sobre preço? Sobre suporte? Sobre comparação técnica? A categoria da pergunta aponta para a origem do problema. E a origem do problema aponta para o tipo de conteúdo que você precisa produzir, ou para as fontes externas onde sua marca precisa aparecer para que a IA passe a considerá-la relevante naquele contexto.
Monitore semana a semana, não só mês a mês
Variações bruscas em poucos dias costumam ter uma causa identificável. Se o Share of Voice de um concorrente subiu 8 pontos em uma semana, provavelmente houve um evento externo: lançamento de produto, cobertura de imprensa, publicação de pesquisa, parceria anunciada. Identificar isso na semana em que acontece permite reagir enquanto a janela de oportunidade ainda está aberta.
Da mesma forma, variações positivas na sua própria visibilidade, depois de uma ação de conteúdo ou de RP, aparecem nos dados em dias, e confirmam (ou refutam) que a ação funcionou. Isso transforma o painel de monitoramento em um sistema de feedback real, não apenas em um relatório de estado.
Use o sentimento para priorizar onde agir primeiro
Se a visibilidade está razoável mas o sentimento está misto ou negativo, a prioridade não é produzir mais conteúdo, mas investigar a origem da narrativa negativa é essencial.
Avaliações em plataformas como Reclame Aqui, Google Reviews ou G2, threads de Reddit com reclamações, artigos comparativos que te posicionam desfavoravelmente são lugares que nunca devem sair do radar.
Publicar um novo case de sucesso não apaga o que a IA já aprendeu de outras fontes. O primeiro passo é sempre entender de onde vem o problema e agir nessa fonte. O conteúdo novo vem depois, como camada adicional de sinal positivo num ambiente onde os sinais negativos ainda têm peso.
Por onde começar: o mínimo viável para ter dados reais
Se você chegou até aqui e está pensando em implementar um sistema de prompt tracking, a pergunta natural é: por onde começo?
A resposta mais honesta é: comece pequeno, mas comece certo. Um banco de 100 a 150 prompts bem construídos, rodando diariamente em dois ou três modelos de IA, produz dados mais úteis do que um banco de 500 prompts genéricos rodando uma vez por semana.
Antes de criar o primeiro prompt, responda três perguntas:
-
Quais são as perguntas que meu cliente faria para a IA no momento em que está mais próximo de uma decisão de compra no meu segmento?
-
Quais concorrentes eu preciso monitorar junto, e quais perguntas provavelmente os fazem aparecer?
-
Em quais modelos de IA meus clientes mais provavelmente estão — ChatGPT, Perplexity, Gemini?
Com essas respostas, você já tem o núcleo do seu banco de monitoramento. O refinamento vem com os dados!
Prompts que não geram nada interessante por semanas precisam ser revistos, e novos prompts precisam ser adicionados conforme você entende melhor onde sua marca está ganhando e perdendo espaço.
E uma última ressalva importante: não use seu próprio nome de marca como prompt de monitoramento (a não ser que a ideia seja falar de sentimento e/ou reputação, claro). Um prompt como "o que é a [sua empresa]?" vai quase sempre gerar uma aparição. Afinal, você está perguntando sobre você mesmo. Isso cria um viés positivo que distorce os dados e não reflete como um cliente real chegaria até você.
Os prompts mais valiosos são os que não citam seu nome e verificam se a IA te seleciona quando simplesmente responde uma pergunta do seu mercado.
A Mentionflow é uma ferramenta brasileira de monitoramento de presença em IA generativa que te ajuda exatamente com isso: prompts cadastrados pelo próprio cliente (com material de apoio para orientar essa construção), execução automática diária nos principais modelos do mercado, e um painel com todas as métricas essenciais para uma boa estratégia de GEO: Visibilidade, Share of Voice, Citações, Menções, Sentimento e Compras, atualizadas todos os dias e apresentadas de forma que qualquer gestor consiga interpretar e agir.
Se quiser entender como sua marca está sendo tratada pelas IAs agora, conheça nossa solução e faça um trial gratuito!
Continue lendo
GEO vs. SEO: o que muda na prática quando você otimiza para IA
GEO e SEO não são opostos. São camadas diferentes sobre a mesma base. Entenda onde cada um age, o que de fato muda no dia a dia e quando priorizar um ou outro.
O que é GEO e por que sua marca precisa aparecer nas respostas da IA
Entenda o que é GEO, como otimizar sua marca para aparecer nas respostas do ChatGPT, Gemini e Perplexity e quais métricas acompanhar.
Brand SEO semântico: o que é uma entidade, por que o Google quer saber quem você é antes de te ranquear e o que isso tem a ver com IA
Entenda como entidades, Knowledge Graph, Schema Markup e corroboração ajudam o Google e as IAs a reconhecer, ranquear e citar sua marca.